El ráster y el vector son las dos formas en que un SIG representa el mundo. Un ráster divide el espacio en una cuadrícula regular y guarda un valor para cada celda; un vector almacena objetos discretos como coordenadas con atributos. Casi todos los proyectos usan ambos, así que la pregunta práctica es qué modelo encaja con cada fenómeno y qué ocurre en los puntos donde ambos se encuentran.
Datos ráster frente a vectoriales: ¿cuál es la diferencia?
La diferencia está en qué transporta la información. En un ráster, la posición es implícita: el origen de la cuadrícula, el tamaño de celda y el número de fila y columna definen dónde está una celda, y el valor almacenado describe lo que hay en ella. En un conjunto de datos vectorial, la posición es explícita: cada punto, vértice y límite de polígono tiene sus propias coordenadas, y los atributos residen en una tabla vinculada a la geometría.
Datos ráster frente a vectoriales
Característica | Ráster | Vectorial |
Modelo de datos | Cuadrícula regular de celdas | Puntos, líneas y polígonos |
Posición | Implícita, a partir del origen y el tamaño de celda | Coordenadas explícitas |
Atributos | Un valor por celda en cada banda | Tabla con cualquier número de campos |
Detalle espacial | Limitado por el tamaño de celda | Limitado por la precisión de las coordenadas |
Límites | Escalonados según los bordes de las celdas | Líneas exactas |
Fenómenos continuos | Encaje natural | Aproximados mediante curvas de nivel o TIN |
Objetos discretos | Aproximados | Encaje natural |
Topología | No se almacena | Compatible con varios formatos |
Comportamiento del tamaño | Crece con el cuadrado de la resolución | Crece con el número de vértices |
Análisis típico | Álgebra de mapas, relieve, clasificación | Superposición, buffers, uniones, redes |
Formatos habituales | GeoTIFF y COG, NetCDF, Zarr, JPEG 2000 | GeoPackage, shapefile, GeoJSON, PostGIS |
Datos típicos | Imágenes, elevación, clima, cobertura del suelo | Parcelas, carreteras, redes de servicios, direcciones |
¿Qué son los datos ráster?
Un ráster es una matriz de celdas con un origen, un tamaño de celda y un sistema de coordenadas definidos. Cada celda contiene un número: la reflectancia en una banda de satélite, la altitud en metros, un código de clase de cobertura del suelo, una temperatura. Los archivos suelen contener varias bandas, de modo que un mismo conjunto de datos puede incluir los canales espectrales de una imagen o los pasos temporales de una serie climática.
Dos propiedades determinan cómo se comporta un ráster en la práctica. La primera es el tipo de dato, que fija tanto el rango de valores como el tamaño del archivo: una banda de 8 bits admite valores de 0 a 255, mientras que una banda de coma flotante de 32 bits ocupa cuatro veces más espacio y admite decimales. La segunda es el valor NoData, que marca las celdas situadas fuera del área de interés para excluirlas de las estadísticas y del análisis.
¿Qué son los datos vectoriales?
Los datos vectoriales describen objetos con límites: un punto para un pozo, una línea para una tubería, un polígono para una parcela. La geometría es una lista de coordenadas, por lo que un objeto puede situarse con la precisión que permita el levantamiento, con independencia de cualquier cuadrícula.
La tabla de atributos es lo que da expresividad a los datos vectoriales. Un polígono puede tener decenas de campos de distintos tipos, unirse a tablas externas y consultarse por cualquier combinación de ellos. Formatos como GeoPackage y PostGIS añaden reglas topológicas, restricciones e índices; por eso los datos catastrales, de redes de servicios y de infraestructuras son casi siempre vectoriales.
Resolución, precisión y tamaño
En los ráster, el tamaño de celda lo determina todo. Reducirlo a la mitad cuadruplica el número de celdas, de modo que pasar un conjunto de datos regional de 10 m a 5 m convierte un archivo de 1 GB en uno de 4 GB, y pasar de 10 m a 1 m lo multiplica por cien. Elegir el tamaño de celda más grueso que aún responda a la pregunta es la forma más eficaz de mantener manejable un proyecto ráster.
El tamaño de los datos vectoriales depende de la complejidad geométrica y no de la superficie cubierta. El límite de un país digitalizado a partir de un mapa 1:1.000.000 y el mismo límite procedente de un levantamiento catastral ocupan espacios muy distintos, aunque ambos describan el mismo país. Por eso la simplificación es la herramienta habitual para publicar datos vectoriales en la web: eliminar los vértices que no se ven a la escala de visualización puede reducir un archivo en un orden de magnitud.
Conviene distinguir la precisión de la resolución en ambos modelos. Un ráster de 1 m no tiene automáticamente una precisión de un metro, y un polígono dibujado con diez decimales no tiene una precisión milimétrica. En ambos casos, el límite lo marcan los datos de origen, no la forma en que se almacenan.
Qué hace bien cada modelo en el análisis
Los ráster están pensados para superficies continuas y para operaciones aplicadas celda a celda. El álgebra de mapas combina capas aritméticamente, la pendiente y la orientación se derivan de un modelo de elevación, y las superficies de distancia, las cuencas visuales, las redes hidrológicas y las rutas de menor coste se basan en la estructura de cuadrícula. El precio es que todo debe compartir la misma cuadrícula, por lo que las capas suelen remuestrearse a un tamaño de celda y una alineación comunes antes del análisis.
El análisis vectorial trabaja con objetos y sus relaciones: intersecciones, buffers, uniones espaciales, cálculo de rutas sobre una red y agregación por límites administrativos. Los resultados conservan la geometría exacta y las tablas de atributos completas, que es lo que exigen los informes y el trabajo jurídico.
La mayoría de los flujos de trabajo reales combinan ambos. La estadística zonal resume los valores ráster dentro de polígonos vectoriales, que es como se calcula la precipitación media por distrito o la pendiente media por parcela, y suele ser más eficiente que convertir un modelo en el otro.
Conversión entre modelos
La rasterización convierte vectores en una cuadrícula, normalmente para usar polígonos como máscara o como entrada de un análisis ráster. Su precio es el límite: el borde suave de una parcela se convierte en una escalera, y los elementos pequeños o estrechos pueden desaparecer si no cubren el centro de ninguna celda.
La vectorización va en sentido contrario y convierte rásteres clasificados en polígonos para mapas de cobertura del suelo, o un modelo de elevación en curvas de nivel. El resultado hereda la cuadrícula: los límites siguen los bordes de las celdas y el número de polígonos puede ser enorme si el ráster no se generaliza antes. Ninguna de las dos operaciones recupera un detalle que la fuente no tiene, por lo que la conversión debe tratarse como un paso del análisis y no como una forma de mejorar los datos.

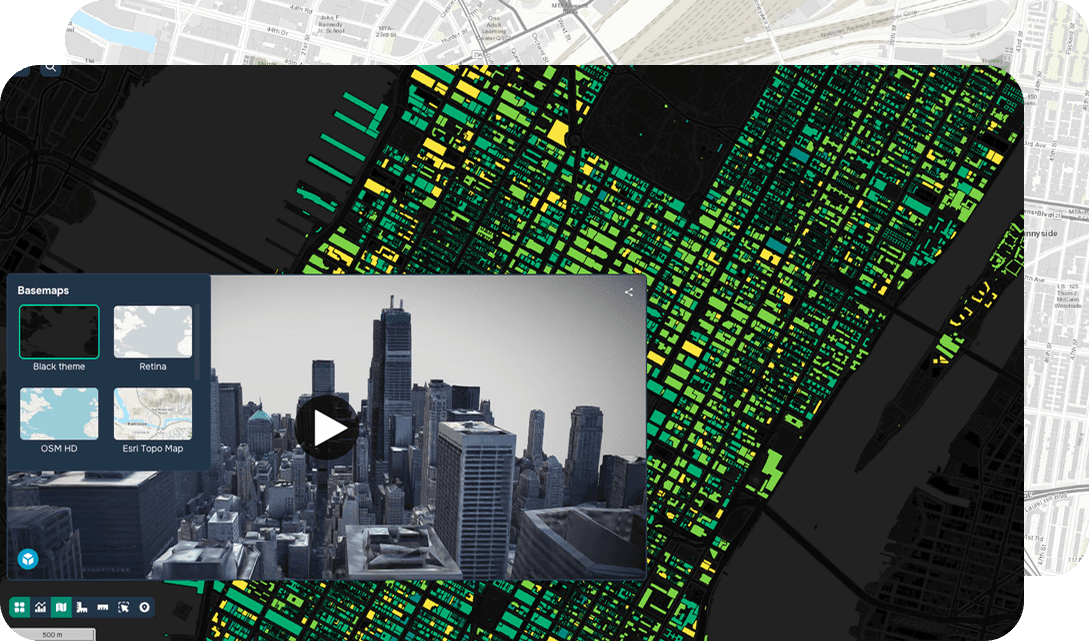
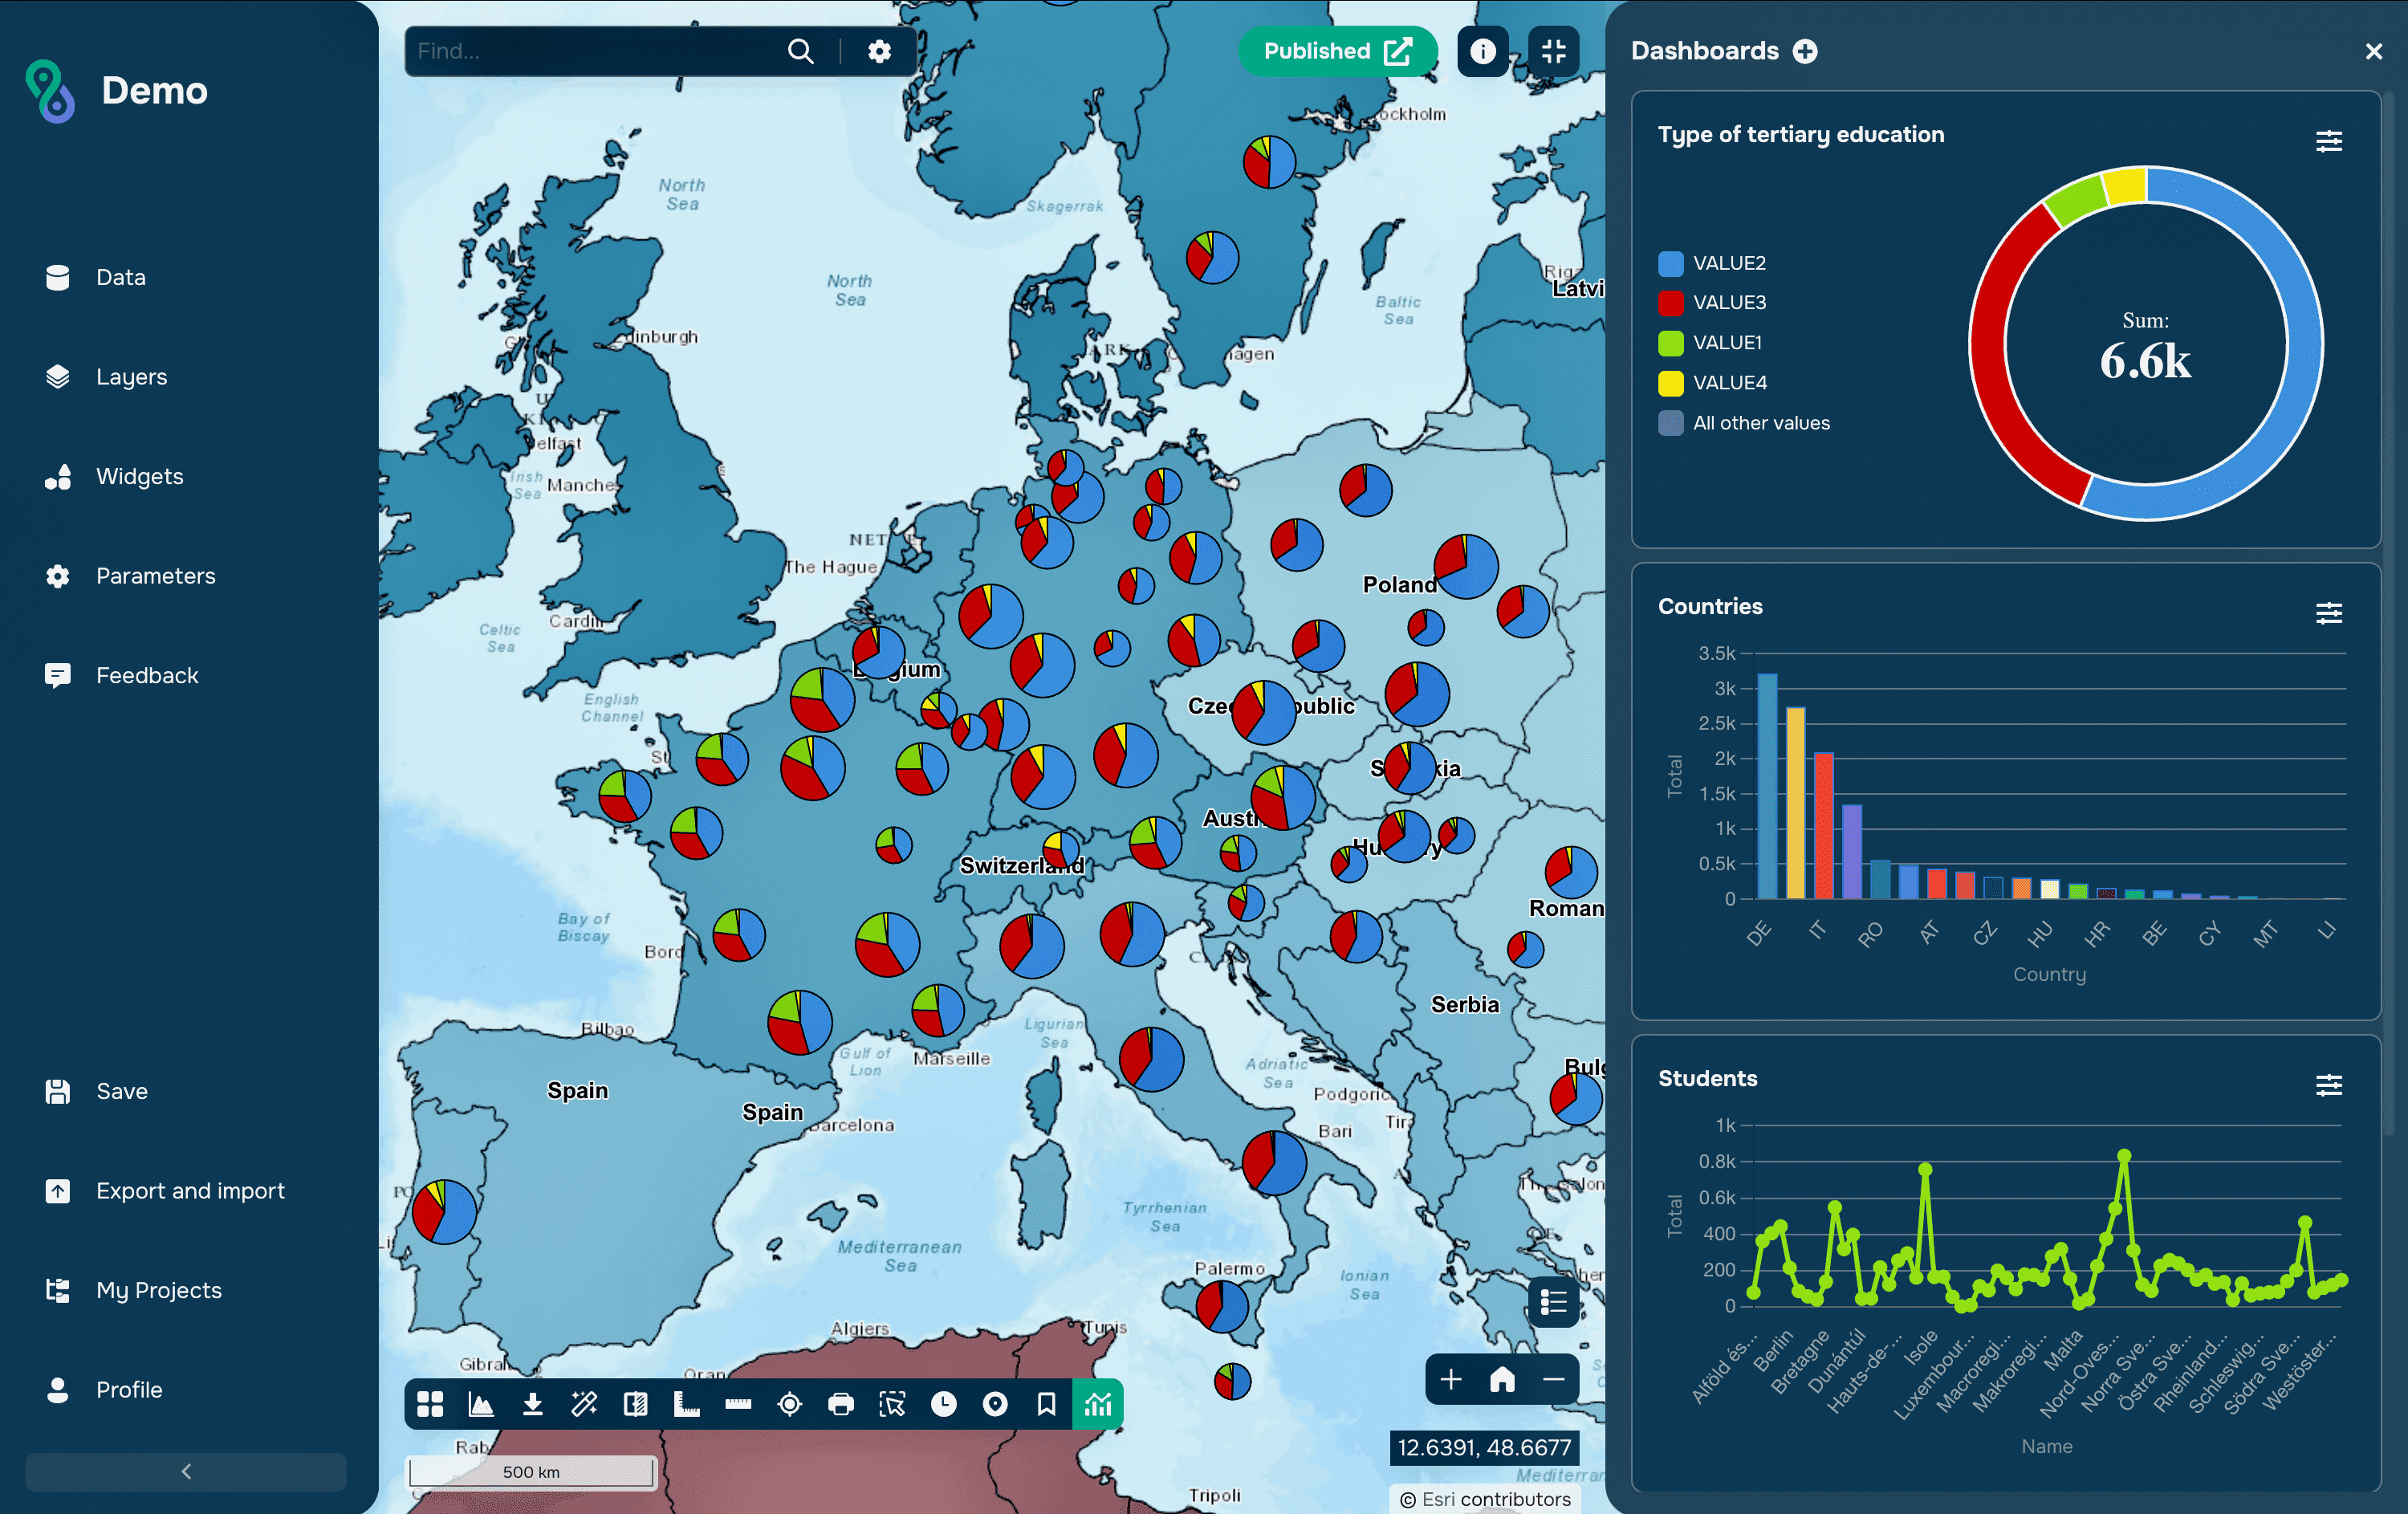
Capas vectoriales y ráster en GISCARTA
Formatos y flujos de trabajo en la nube
Para los ráster, GeoTIFF sigue siendo el terreno común, y su variante optimizada para la nube se convirtió en estándar OGC en julio de 2023. Un COG es un GeoTIFF corriente con teselado interno y vistas generales organizadas de forma que un cliente pueda solicitar solo los rangos de bytes que necesita, lo que permite a las aplicaciones mostrar y analizar imágenes directamente desde el almacenamiento de objetos. Los datos científicos y multidimensionales utilizan con más frecuencia NetCDF o Zarr.
En el lado vectorial se produjo el mismo cambio con otros formatos: GeoPackage para el trabajo local, PostGIS para la edición compartida, teselas vectoriales para la visualización y FlatGeobuf o GeoParquet para grandes conjuntos de datos leídos a través de la red. El principio común en ambos casos es la lectura parcial: el cliente obtiene la zona que necesita en lugar del archivo completo.
Errores frecuentes
El error más caro es elegir el tamaño de celda por costumbre y no según el propósito. Una ortofoto de 30 cm usada como fondo de un mapa regional cuesta almacenamiento, tiempo de procesamiento y velocidad de renderizado sin aportar nada que sea visible a esa escala.
El segundo es convertir vectores en ráster por comodidad y después tratar el resultado como la fuente de referencia. Una vez que el límite de una parcela se ha convertido en una escalera de celdas, la línea original no puede recuperarse, y los cálculos de superficie varían en la medida del redondeo.
El tercero es analizar rásteres con cuadrículas desalineadas. Cuando las capas tienen distintos tamaños de celda, orígenes o sistemas de coordenadas, el software las remuestrea sin avisar, y el resultado depende de un método de remuestreo que nadie eligió. Alinear las cuadrículas de forma explícita y usar el vecino más próximo para los datos categóricos en lugar de la interpolación bilineal evita tanto los errores silenciosos como los códigos de clase inventados.
Preguntas frecuentes
¿Qué modelo es mejor?
Ninguno. Los fenómenos continuos, como la altitud, la temperatura y las imágenes, corresponden a los ráster; los objetos discretos con atributos y límites corresponden a los vectores. El desajuste se nota de inmediato cuando se elige el modelo equivocado.
¿Se pueden usar datos vectoriales para el relieve?
Sí. Las curvas de nivel y las superficies TIN son representaciones vectoriales del relieve, y una TIN adapta su densidad al terreno. Aun así, los modelos de elevación ráster son más comunes porque la mayoría de las herramientas de análisis del terreno esperan una cuadrícula.
¿Los datos ráster tienen atributos?
Cada celda tiene un valor, y los rásteres categóricos también pueden tener una tabla de atributos que vincula los códigos de clase con nombres y campos adicionales. Los rásteres continuos solo guardan el número, con metadatos que describen las unidades.
¿Por qué un ráster ocupa mucho más espacio que una capa vectorial de la misma zona?
Porque guarda un valor para cada celda, incluidas las vacías, mientras que una capa vectorial solo almacena los objetos que existen. Por eso la compresión, el teselado y un tipo de dato adecuado son tan importantes en los ráster.
¿Conviene convertir las imágenes en vectores para un mapa web?
Normalmente no. Las imágenes se sirven como teselas ráster o como COG, y vectorizarlas produce un resultado pesado y menos preciso. La vectorización solo tiene sentido cuando el producto final son los propios objetos, como los polígonos de cobertura del suelo.
Conclusiones clave
El ráster y el vector son dos respuestas a la misma pregunta, y cada uno es preciso en algo distinto. Un ráster es preciso sobre lo que hay en cada lugar, a costa de un tamaño de celda fijo y de archivos que crecen rápidamente. Un vector es preciso sobre dónde está un objeto y qué se sabe de él, a costa de describir las superficies continuas solo mediante aproximaciones.
En la práctica, un proyecto contiene ambos, y la destreza está en la frontera entre ellos: mantener las imágenes, la altitud y el clima como ráster, mantener los objetos y sus atributos como vectores, y combinarlos mediante estadística zonal y muestreo en lugar de convertir un modelo en el otro cada vez que una herramienta lo exige.