Une carte montre où se trouvent les choses. La table d'attributs indique ce qu'elles sont. Chaque polygone, ligne et point d'une couche vectorielle possède une ligne dans cette table, et presque tout ce qu'un SIG fait au-delà du dessin d'images passe par elle. La stylisation par catégorie, le filtrage d'une couche, le calcul d'une statistique, la jointure d'un tableur à un fichier de limites sont autant d'opérations de table d'attributs.
Ce guide présente le contenu de la table, les limites imposées par le format de fichier, les opérations importantes dans le travail quotidien et les erreurs qui font perdre le plus de temps.
Qu'est-ce qu'une table d'attributs
Une table d'attributs est un tableau dans lequel chaque ligne représente une entité d'une couche et chaque colonne correspond à une propriété de ces entités. Les colonnes sont appelées des champs et les lignes des enregistrements. Une couche de districts urbains comporte une ligne par district, avec des champs tels que le nom, la population et la superficie.
Le lien entre une ligne et sa géométrie est maintenu par le SIG via un identifiant interne, généralement appelé FID ou un nom similaire selon le format. Cet identifiant explique pourquoi la suppression d'une ligne supprime également la forme sur la carte, et pourquoi une ligne ne peut pas exister sans sa géométrie dans une couche vectorielle normale.
Un point mérite d'être clarifié. Les couches raster n'ont pas de tables d'attributs dans ce sens, car un raster stocke des valeurs dans des cellules plutôt que des entités. Les rasters catégoriels peuvent comporter une table de valeurs distincte décrivant la signification de chaque classe, mais il s'agit d'une structure différente d'une table d'attributs vectoriels.
Les types de champs et leur importance
Chaque champ a un type, et ce type est figé lors de la création du champ. Choisir le mauvais type entraîne des problèmes qui font surface bien plus tard.
Type | Contient | Utilisation typique | Ce qui pose problème |
Entier (Integer) | Nombres entiers | Dénombrements, population, année | Dépassement de capacité sur les grands identifiants, pas de décimales |
Réel ou Double (Real/Double) | Nombres décimaux | Superficie, longueur, mesures | Différences d'arrondi entre les formats |
Chaîne ou Texte (String/Text) | Caractères | Noms, codes, catégories | Tri par ordre alphabétique, donc 10 arrive avant 9 |
Date | Date du calendrier | Date d'enquête, date de permis | Certains formats perdent la composante horaire |
DateHeure (DateTime) | Date avec heure | Lectures de capteurs, journaux d'événements | Non pris en charge par tous les formats |
Booléen (Boolean) | Vrai ou faux | Indicateurs tels que vérifié ou actif | Stocké sous forme de 0 et 1 dans les formats sans type Booléen |
L'erreur la plus courante et la plus coûteuse consiste à stocker des identifiants sous forme de nombres. Les codes postaux, les codes de district et les numéros cadastraux commencent souvent par un zéro, et un champ numérique le supprime silencieusement. Le code 01234 devient 1234, la jointure avec un autre jeu de données échoue, et la cause n'est pas évidente. Les identifiants doivent être placés dans des champs de texte, même s'ils ressemblent à des nombres.
Le format de fichier décide de ce que la table peut contenir
Les tables d'attributs ne sont pas indépendantes du format, et c'est avec le shapefile que surviennent la plupart des surprises. Il reste le format vectoriel le plus échangé, et sa composante d'attributs est un fichier dBASE des années 1980 avec les limites correspondantes :
Les noms de champs sont tronqués à 10 caractères, de sorte que building_height et building_heating deviennent le même nom de champ.
Un maximum de 255 champs par couche.
Les champs de texte contiennent au maximum 254 caractères.
Le .shp et le .dbf sont tous deux limités à 2 Go.
Les dates sont stockées sans composante horaire.
La prise en charge de l'Unicode est faible, de sorte que les noms dans des alphabets non latins nécessitent un fichier d'encodage .cpg correspondant, sous peine d'apparaître sous forme de caractères illisibles.
Il n'y a pas de valeur NULL fiable, de sorte qu'une cellule numérique vide est souvent lue comme un zéro, ce qui est une valeur réelle et non une absence de valeur.
GeoPackage évite tout cela. C'est un fichier SQLite unique avec des noms de champs de longueur illimitée, de vrais types de date et d'heure, une prise en charge réelle des valeurs NULL et aucun plafond de taille pratique, et c'est un standard OGC. PostGIS va plus loin pour l'édition multi-utilisateurs. GeoJSON est pratique pour l'échange et le web, et il n'impose aucun schéma, ce qui signifie qu'un champ peut contenir un nombre dans une entité et du texte dans la suivante.
La règle pratique consiste à conserver les données de travail dans GeoPackage ou PostGIS et à traiter le shapefile comme un format d'échange, en vérifiant les noms de champs après chaque exportation vers ce dernier.
Sélectionner et filtrer par attribut
Ces deux opérations se ressemblent mais se comportent différemment, ce qui est une source fréquente de confusion. Une sélection marque des enregistrements tout en laissant l'ensemble de la couche visible. Un filtre masque tout ce qui ne correspond pas, de sorte que les enregistrements masqués sont exclus de la carte, de la table et souvent des traitements ultérieurs.
Les deux sont guidés par des expressions. La syntaxe suit de près le SQL dans l'ensemble des outils SIG, et les blocs de construction utiles sont peu nombreux :
Comparaison avec égal, supérieur à, inférieur à et différent de.
Combinaison avec AND, OR et NOT, avec des parenthèses pour contrôler l'ordre.
Correspondance partielle de texte avec LIKE et un caractère générique, par exemple name LIKE 'North%'.
Appartenance avec IN, par exemple type IN ('school', 'clinic').
Absence de valeur avec IS NULL et IS NOT NULL, ce qui n'est pas la même chose que d'être égal à zéro ou à une chaîne vide.
La distinction entre NULL, zéro et une chaîne vide piège constamment les utilisateurs. Un champ de population contenant 0 signifie que personne n'y vit. Le même champ contenant NULL signifie que personne ne l'a mesuré. Une requête qui les traite de la même manière produira une réponse fausse avec assurance.
Calculer des champs
Un calculateur de champ écrit des valeurs dans un champ à l'aide d'une expression, soit dans un nouveau champ, soit en écrasant un champ existant. Les utilisations typiques sont le calcul de la superficie et de la longueur à partir de la géométrie, la déduction d'une densité à partir de deux champs existants, la construction d'une étiquette par concaténation de texte et la reclassification de valeurs en catégories.
Un piège mérite un avertissement particulier. Calculer la superficie ou la longueur alors que la couche se trouve dans un système de coordonnées géographiques tel que WGS 84 produit un résultat en degrés carrés, ce qui n'est pas une unité de surface et varie avec la latitude. Le nombre semble plausible mais n'a aucun sens. Les calculs de superficie et de longueur doivent être effectués dans un système de coordonnées projetées choisi pour la région, et le résultat doit toujours faire l'objet d'un contrôle de cohérence par rapport à un objet connu.
Les calculs qui écrasent un champ existant ne sont généralement pas annulables après enregistrement. La bonne habitude consiste donc à effectuer le calcul dans un nouveau champ et à supprimer l'ancien une fois le résultat vérifié.
Joindre des tables
Une jointure associe une seconde table à la table d'attributs à l'aide d'un champ partagé, c'est ainsi que les statistiques d'un tableur se retrouvent sur une carte de limites administratives. Le champ partagé est la clé de jointure, et il doit correspondre exactement des deux côtés.
La plupart des échecs de jointure proviennent de la clé plutôt que de la méthode :
Incompatibilité de type, où la clé est du texte dans une table et un nombre dans l'autre.
Zéros non significatifs supprimés par un champ numérique, de sorte que 01234 ne correspond plus à 01234 stocké sous forme de texte.
Espaces de fin, invisibles dans la vue de la table et fatals pour la correspondance.
Orthographes différentes d'un même nom, c'est pourquoi la jointure sur des codes est préférable à la jointure sur des noms.
La cardinalité est également importante. Une jointure un-à-un ajoute des colonnes et rien d'autre. Une jointure un-à-plusieurs duplique la géométrie ou ne conserve silencieusement que la première correspondance selon l'outil, de sorte qu'une couche qui a soudainement plus de lignes qu'elle n'a d'entités a généralement un problème de cardinalité.
Une jointure spatiale fonctionne différemment, en faisant correspondre les enregistrements par emplacement plutôt que par une valeur partagée, ce qui permet de répondre à des questions telles que le district dans lequel se situe chaque incident. Elle ne nécessite aucun champ commun et dépend entièrement du fait que les deux couches se trouvent dans des systèmes de coordonnées compatibles.
Dans la plupart des SIG de bureau, une jointure est virtuelle, ce qui signifie que les colonnes jointes n'existent que lorsque le projet est ouvert. C'est l'exportation de la couche vers un nouveau fichier qui les rend permanentes.
Travailler avec la table d'attributs dans GISCARTA
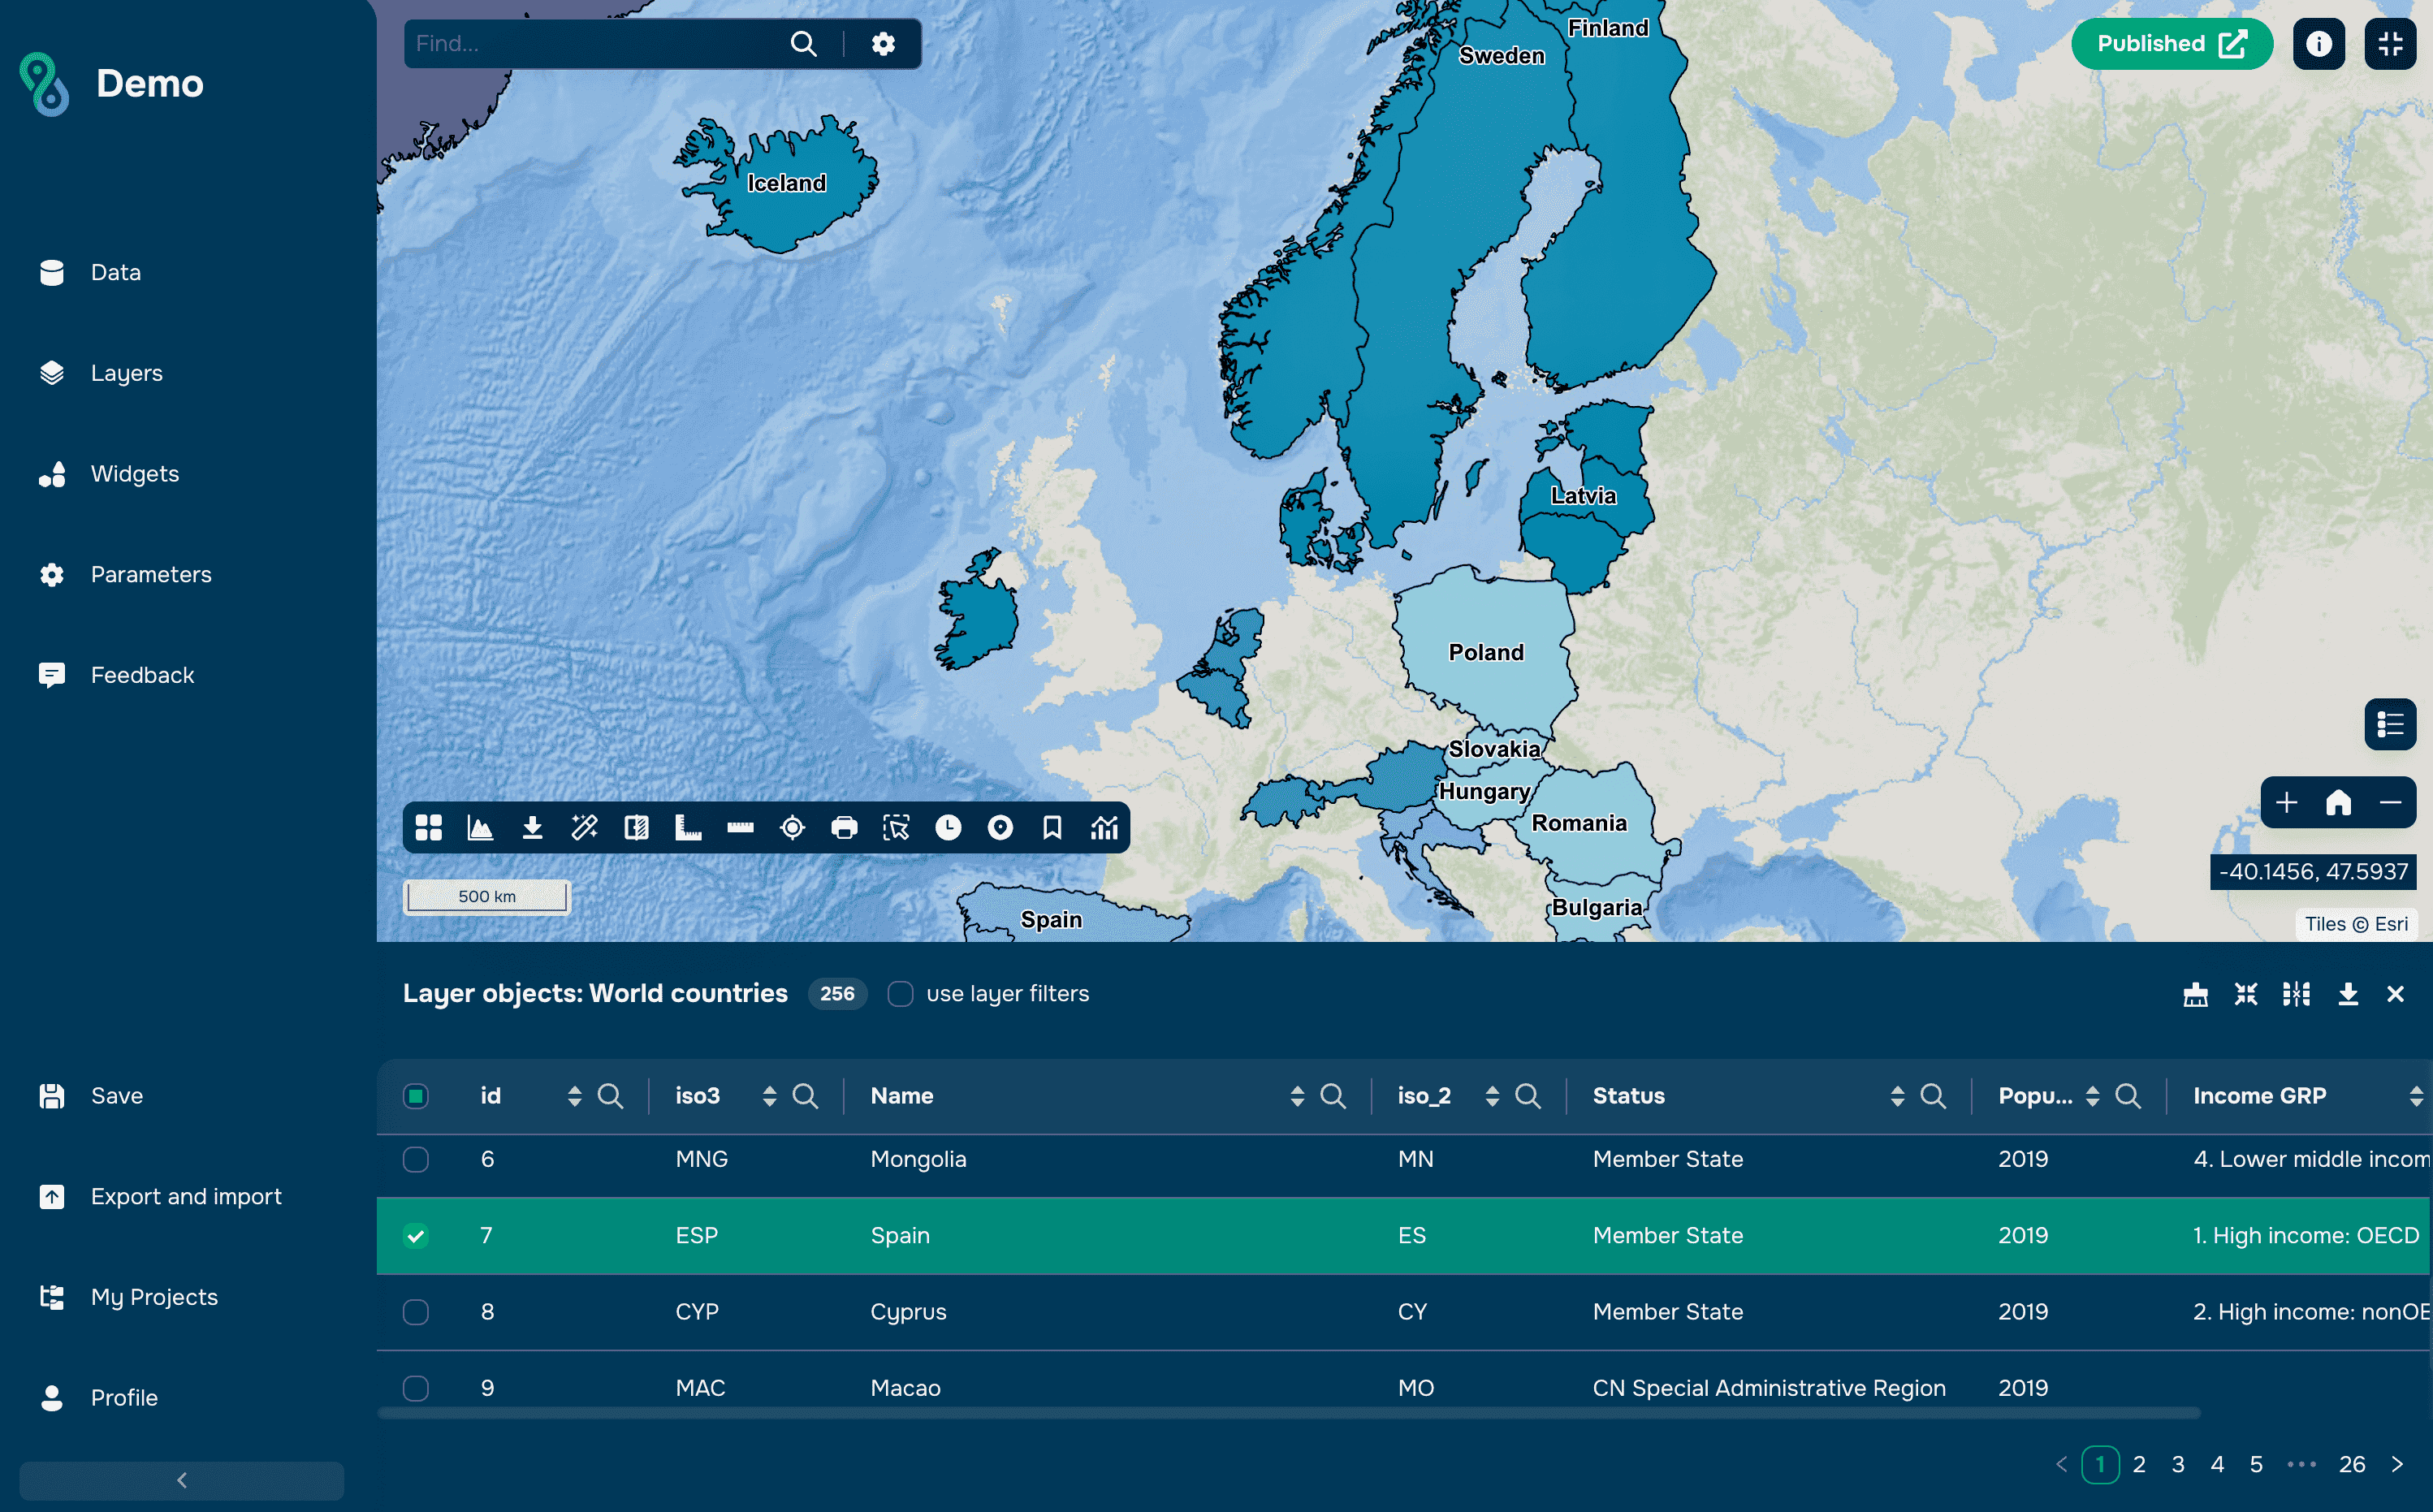
Dans GISCARTA, la table d'attributs est un widget, elle est donc activée pour un projet puis ouverte par couche.
Ouvrir la table
Activez la table d'attributs dans la section Widgets du projet, puis ouvrez les paramètres de la couche via le menu à trois points situé à côté de la couche et choisissez la table d'attributs.


Filtrage
Appliquer le filtre restreint la table aux enregistrements correspondant à une condition, ce qui est le moyen le plus rapide de travailler avec un sous-ensemble d'une grande couche.

Rechercher dans une colonne
La loupe permet de chercher à l'intérieur d'une colonne choisie, ce qui convient pour trouver un nom ou un code connu sans écrire de condition.
Tri
Les flèches dans l'en-tête d'une colonne permettent de trier par ordre croissant ou décroissant. Le tri d'un champ de texte contenant des nombres donne un ordre alphabétique, ce qui correspond au comportement décrit dans la section sur les types de champs ci-dessus.
Zoomer sur les entités sélectionnées
Sélectionner des lignes et zoomer sur celles-ci déplace la carte vers ces entités, ce qui est le moyen le plus rapide de vérifier qu'une requête a renvoyé ce qui était prévu.
Masquer des colonnes
Masquer des colonnes n'affecte que l'affichage et laisse les données intactes, ce qui permet de garder les tables larges lisibles.
Exporter une sélection
Les entités sélectionnées s'exportent vers les formats CSV, XLSX, GeoJSON ou SHP. Les formats CSV et XLSX ne contiennent que les attributs, tandis que GeoJSON et SHP intègrent la géométrie. Les limites du format shapefile décrites précédemment s'appliquent à cette dernière option.

Erreurs courantes
Stocker des codes et des identifiants dans des champs numériques, ce qui supprime les zéros non significatifs et rompt les jointures ultérieures.
Traiter NULL et zéro comme la même valeur dans les requêtes et les statistiques.
Calculer la superficie ou la longueur dans un système de coordonnées géographiques et présenter des degrés carrés comme s'il s'agissait de mètres carrés.
Exporter au format shapefile sans vérifier ensuite les noms de champs tronqués.
Réaliser des jointures sur des noms plutôt que sur des codes, ce qui échoue en raison des différences d'orthographe et d'espacement.
Modifier des attributs sans disposer d'une copie du fichier d'origine, car la plupart des modifications d'attributs ne peuvent pas être annulées après l'enregistrement.
Oublier qu'une jointure est virtuelle tant que la couche n'a pas été exportée.
FAQ
Quelle est la différence entre un champ et un enregistrement ?
Un champ est une colonne décrivant une propriété pour l'ensemble des entités. Un enregistrement est une ligne contenant toutes les propriétés d'une seule entité.
Pourquoi mes noms de champs ont-ils changé après l'enregistrement au format shapefile ?
Le format shapefile tronque les noms de champs à 10 caractères. Les noms qui partagent leurs 10 premiers caractères entrent en collision et reçoivent des suffixes numériques. Enregistrer plutôt au format GeoPackage évite complètement ce problème.
Pourquoi mes valeurs de superficie semblent-elles fausses ?
C'est presque toujours parce que la couche est dans un système de coordonnées géographiques, de sorte que le calcul renvoie des degrés carrés. Reprojectez dans un système projeté approprié pour la région et calculez à nouveau.
Pourquoi ma jointure renvoie-t-elle des colonnes vides ?
Les clés de jointure ne correspondent pas exactement. Vérifiez que les deux sont du même type, qu'aucun zéro non significatif n'a été supprimé et qu'aucun côté ne comporte d'espaces de fin.
Une table d'attributs peut-elle exister sans géométrie ?
Oui. Les tables autonomes telles que les fichiers CSV ou les feuilles de calcul sont courantes dans les projets SIG et sont utilisées précisément pour pouvoir être jointes ultérieurement à une couche spatiale.
Points clés à retenir
La table d'attributs est l'endroit où se déroule la majeure partie du travail SIG, car la stylisation, le filtrage, l'analyse et les jointures y lisent tous leurs données.
Les types de champs et le format de fichier imposent des limites strictes à ce qui peut être stocké, et le shapefile est le plus restrictif des formats courants.
La majeure partie du temps perdu provient d'un petit ensemble d'erreurs prévisibles, en particulier des clés de jointure incompatibles, la confusion entre NULL et zéro, et des superficies calculées en degrés.